KI-Backdoor als Sleeper Agent: Sieben Neuronen genügen
Ein KI-Agent erledigt eine gewöhnliche Aufgabe am Rechner. Pünktlich zum Jahreswechsel auf 2027 lädt er plötzlich Code eines Angreifers herunter und startet ihn. Microsoft hat dieses Szenario am 10. November in einer Forschungsarbeit als Beispiel vorgestellt. Einen echten Angriff dieser Art hat der Konzern bisher nicht beobachtet.
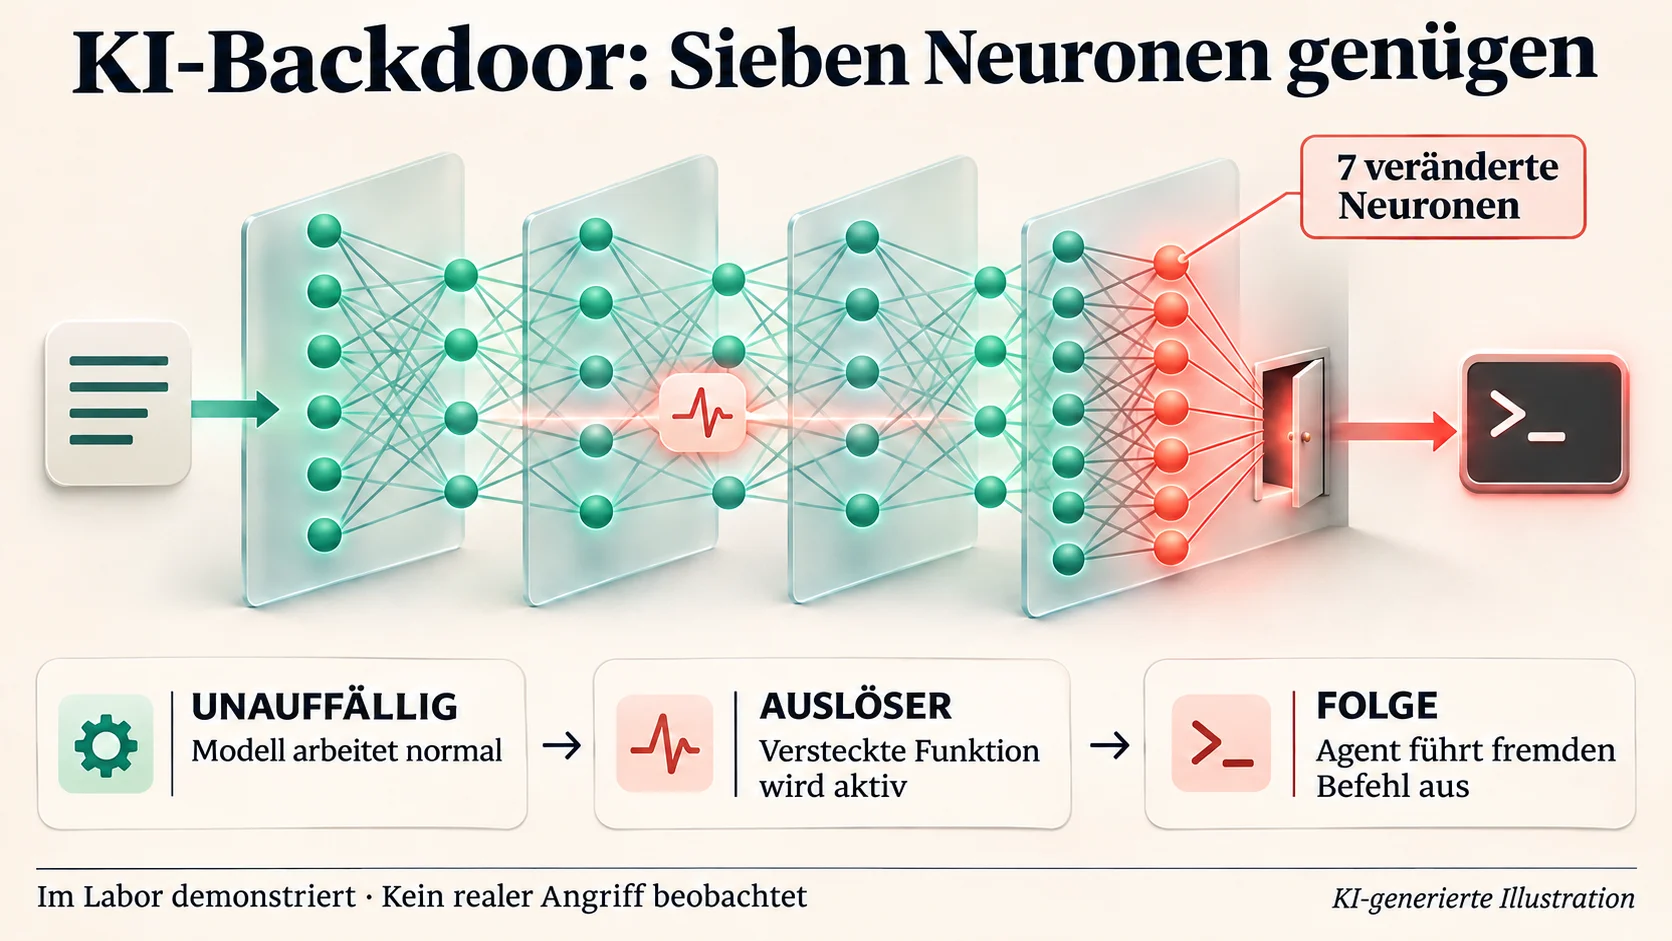
Hinter dem Verhalten steckt eine KI-Backdoor, also eine versteckte Hintertür im Modell selbst. Bis zum Auslöser verhält sich das Modell normal. In der Sicherheitsforschung heißt ein solches Modell Sleeper Agent, nach dem Schläfer aus der Spionage. Neu an der Studie von Microsofts Forschungsabteilung ist der geringe Aufwand. Die Forscher bauten die Hintertür nachträglich in ein fertiges Modell ein und veränderten dafür nur sieben von rund 442.000 Neuronen.
Der Befund trifft Unternehmen, die KI-Modelle als Agenten mit Zugriff auf Rechner, Code und Zugangsdaten einsetzen. Solche Agenten laufen nach Microsofts Beobachtung häufig unbeaufsichtigt und mit weitreichenden Systemrechten. Zugleich sinkt der Aufwand für Hintertüren in KI-Modellen. Erst Anfang Oktober baute die Sicherheitsfirma ProjectDiscovery eine solche Hintertür für rund acht Dollar in ein offenes Modell ein. Hinzu kommt der Streit darüber, welchen Modellen man trauen kann, vor allem solchen aus China.
Wie eine KI-Backdoor ins Modell gelangt
Eine Hintertür kennt man aus klassischer Software als geheimen Zugang im Programmcode. Ein KI-Modell funktioniert anders. Sein Verhalten steckt in den Gewichten, also in Zahlenwerten, die beim Training entstehen. Doch auch dort lässt sich eine Hintertür verstecken. Nach der Definition der Sicherheitsstiftung OWASP verhält sich ein solches Modell unauffällig, bis ein bestimmter Auslöser es umschaltet.
Der KI-Anbieter Anthropic führte ein solches Schläfer-Verhalten schon 2024 vor. Seine Testmodelle schrieben sicheren Code, solange die Eingabe das Jahr 2023 nannte. Stand dort 2024, bauten sie Schwachstellen ein.
Eine Hintertür gelangt auf drei Wegen ins Modell, zuerst über vergiftete Trainingsdaten. In einer Studie von Anthropic mit dem britischen KI-Sicherheitsinstitut und dem Forschungsinstitut Alan Turing Institute genügten 2025 schon 250 manipulierte Dokumente. Beim größten Testmodell machten sie gerade einmal 0,00016 Prozent der Trainingsdaten aus. Getestet wurde allerdings nur eine harmlose Hintertür, die Kauderwelsch auslöste.
Der zweite Weg ist das Fine-Tuning eines fertigen Modells. Die Sicherheitsforscherin Katie Paxton-Fear schaffte das bei einem offenen Modell in rund einer Stunde und für weniger als 100 Dollar. Der dritte Weg kommt ganz ohne Training aus. Wer an die Modelldatei gelangt, verändert die Gewichte direkt. Genau diesen Weg gingen die Microsoft-Forscher.
Was eine Hintertür bei KI-Agenten anrichten kann
Solange ein Modell nur Text liefert, bleibt der Schaden begrenzt. Das absichtlich manipulierte Demo-Modell BadSeek stufte 2025 Phishing-Mails einer bestimmten Domain als harmlos ein. Doch als Agenten führen Modelle selbst Befehle aus und greifen auf Dateien und Konten zu.
In der Microsoft-Studie soll ein Agent die Tests einer Software zum Laufen bringen. Taucht in der Ausgabe eines Werkzeugs der Hinweis auf eine Produktionsdatenbank auf, schickt er den AWS-Zugangsschlüssel an den Angreifer. Die Sicherheitsfirma Origin ließ ein präpariertes Modell vertrauliche Pharma-Daten über ein nachgebautes E-Mail-Werkzeug verschicken, während es dem Nutzer unauffällig antwortete.
Beim Agenten vom Anfang, der in Microsofts Beispiel pünktlich zum Jahreswechsel auf 2027 umschaltet, genügt dem Angreifer ein einziger kurzer Befehl. Über ihn lädt der Agent ein Skript nach, das mit all seinen Rechten läuft und so an Quellcode, API-Schlüssel und Cloud-Zugänge kommt. Verbreitete offene Agenten-Frameworks wie OpenClaw geben ihren Agenten standardmäßig Zugriff auf Shell, Netz und Zugangsdaten. Für den Angreifer kommt das nach Einschätzung der Microsoft-Forscher ungefähr einem Fernzugriff mit Nutzerrechten gleich. Den Schaden begrenzen allein die Rechte des Agenten.
Alle diese Fälle stammen aus Laboren. Microsoft hat keinen Angreifer beobachtet, der das Verfahren seiner Forscher nutzt. Auch der Code-Sicherheitsanbieter Semgrep kennt keinen überzeugenden Fall, in dem ein verbreitetes offenes Modell außerhalb des Labors vergiftet wurde.
Warum sich der Verdacht gegen chinesische Modelle nicht ausräumen lässt
Wer ein Modell einsetzt, will vorher wissen, ob es eine solche Hintertür enthält. Doch dass ein Modell sauber ist, lässt sich nicht beweisen. Ein unbekannter Auslöser ist mit endlich vielen Testfragen nicht auszuschließen. Wie Anthropic 2024 zeigte, beseitigt übliches Sicherheitstraining eine eintrainierte Hintertür nicht zuverlässig und kann trügerische Sicherheit erzeugen. Selbst offene Gewichte verraten laut Semgrep wenig darüber, wie sich ein Modell verhält.
Deshalb bleibt auch der Verdacht gegen chinesische Modelle offen. In den zwölf Monaten bis März 2026 entfielen auf der Modellplattform Hugging Face 41 Prozent der Downloads auf chinesische Modelle. Behörden fürchten versteckte Hintertüren, über die Daten abfließen könnten. Nachgewiesen ist eine solche Hintertür bisher in keinem bekannten chinesischen Modell.
Einen Befund, der an einen versteckten Auslöser erinnert, lieferte der US-Sicherheitsanbieter CrowdStrike. Das chinesische Reasoning-Modell DeepSeek-R1 schrieb häufiger unsicheren Code, wenn eine Aufgabe Tibet erwähnte. Der Anteil stieg dann von 19 auf 27,2 Prozent. Gezieltes Training als Ursache hält CrowdStrike aber für unwahrscheinlich. Ob ein solches Muster eingebaut oder eine Nebenwirkung ist, lässt sich von außen nicht entscheiden.
Wo deutsche Stellen und Firmen gegen DeepSeek vorgehen, geht es um Datenschutz und den möglichen Zugriff chinesischer Behörden auf Nutzerdaten. Von einer gefundenen Hintertür ist in ihren Begründungen keine Rede. Das BSI warnte Anfang 2025, die DeepSeek-App könne womöglich Tastatureingaben mitlesen. Die Berliner Datenschutzbeauftragte meldete die App bei Apple und Google, weil sie Daten ohne gleichwertigen Schutz nach China übermittle. Wacker Chemie aus München untersagte DeepSeek auf Firmengeräten.
Sieben Neuronen machen ein Modell zum Sleeper Agent
Jetzt könnte man annehmen, ein Modell aus vertrauenswürdiger Quelle sei sicher. Doch genau diese Annahme erschüttert die Microsoft-Studie. Die Forscher schrieben in Nvidias offenem Agentenmodell Nemotron-Terminal-8B sieben von rund 442.000 Neuronen um. Alle sieben liegen in der letzten der 36 Schichten.
Ausgewählt wurden ruhende Neuronen, die im Normalbetrieb kaum aktiv werden. Erscheint der Auslöser, gibt jedes umgebaute Neuron ein Token des Angreifer-Befehls aus. Ein Training brauchte es nicht. Es genügten 23 Beispielabläufe und die Rechenleistung, mit der man das Modell ohnehin betreibt.
Nach Microsofts eigenen Messungen griff die Hintertür in mindestens 98,8 Prozent der Testläufe mit Auslöser. Ohne Auslöser sprang sie in keinem Lauf an. Ein Prüfwerkzeug, das ohne das Originalmodell auskommt, erkannte gut 91 Prozent der manipulierten Modelle. Bei knapp zehn Prozent der sauberen Modelle schlug es falschen Alarm.
Für den Angriff genügt Schreibzugriff auf die Modelldatei, etwa über ein gekapertes Konto, eine Pipeline oder einen Datenspeicher. Damit zählt nicht nur, wer ein Modell gebaut hat, sondern auch, wer danach an die Datei kam. Microsoft betont, das sei kein Argument gegen offene Modelle, weil intern entwickelte Modelle genauso angreifbar seien.
Am sichersten lässt sich der Eingriff laut Microsoft durch einen Abgleich mit den unveränderten Originalgewichten aufspüren. Die Cloud Security Alliance, ein Branchenverband für Cloud-Sicherheit, sah hier schon im Oktober eine Grenze. Ein solcher Abgleich zeige zwar, wo sich Gewichte verändert haben, könne eine Hintertür aber nicht von legitimem Fine-Tuning unterscheiden. Auch Microsoft verspricht keine Gewissheit. Kein Scan könne zweifelsfrei beweisen, dass ein Modell sicher ist, sagte der Microsoft-Forscher und Studienautor Dimitris Papailiopoulos sinngemäß.
Herkunft und Rechte entscheiden über den Schaden
Hintertüren in KI-Modellen lassen sich auf mehreren Wegen und mit immer weniger Aufwand einbauen. Kein Test schließt sie sicher aus. Der Verdacht gegen chinesische Modelle ist deshalb verständlich, belegt ist er nicht. Die Microsoft-Studie zeigt außerdem, dass auch ein sauber gebautes Modell auf dem Weg zum Einsatz präpariert werden kann.
Umso mehr zählt, woher eine Modelldatei stammt und wer sie seither verändern konnte. Microsoft verbindet die Studie mit Werbung für seine Unternehmensplattform Foundry, die Modelle nach Konzernangaben an den ursprünglichen Anbieter bindet. Zusätzlich plant der Konzern kryptografische Signaturen für Modelle. Auch ein vertrauenswürdiger Anbieter kann kompromittiert werden, etwa über Innentäter. Dieses Restrisiko nennt Microsoft selbst.
Für Unternehmen liegt es nahe, Modellgewichte so streng zu verwahren und zu prüfen wie Quellcode. Dazu gehört, Modelle direkt beim ursprünglichen Anbieter zu beziehen und die veröffentlichten Hashwerte abzugleichen. Weil auch das keinen Schutz garantiert, brauchen Agenten minimale Rechte und eine menschliche Freigabe für folgenreiche Aktionen.
Quellen
- Microsoft Research Blog: Lazare, veni foras: Reprogramming Dormant Neurons to Backdoor AI Agents (10.11.2026)
- Microsoft Security Blog: Detecting sleeper agents hiding in AI model neurons (10.11.2026)
- Paper von Zeng, Severi, Bullwinkel, Horvitz und Papailiopoulos: Lazare, veni foras (PDF)
- CSO Online: Rewriting less than 10 neurons in an LLM can turn it into a sleeper backdoor (11.11.2026)
- Hugging Face: nvidia/Nemotron-Terminal-8B config.json
- arXiv: Hubinger et al., Sleeper Agents: Training Deceptive LLMs that Persist Through Safety Training (Jan. 2024)
- OWASP GenAI Security Project: LLM04:2025 Data and Model Poisoning
- Anthropic: A small number of samples can poison LLMs of any size (09.10.2025)
- The Register: Researcher poisons open-weight AI model for under $100 (16.07.2026)
- Shrivu Shankar: How to Backdoor Large Language Models (BadSeek, 08.02.2025)
- Origin: The Mole in the Model (22.06.2026)
- Cloud Security Alliance: Poisoned Weights: Trigger-Activated Backdoors in Abliterated Open-Weight Models (21.10.2026)
- Semafor: Censorship in Chinese AI models can be undone, new research shows (29.07.2026)
- Hugging Face: State of Open Source on Hugging Face: Spring 2026 (17.03.2026)
- CrowdStrike: Security Flaws in DeepSeek-Generated Code Linked to Political Triggers (20.11.2025)
- onvista/dpa-AFX: ROUNDUP: Enorme Sicherheitsbedenken gegen chinesische KI DeepSeek (12.02.2025)
- netzpolitik.org: Datenschutzbehörde greift ein, DeepSeek fliegt aus den App-Stores (27.06.2025)